


 IA / ML
 Développement de logiciels


Comment nous avons construit un système d’IA pour l’analyse de la langue basé sur la MTC
Client
Le client développe des services de diagnostic numériques dans le domaine de la médecine traditionnelle chinoise (MTC), où l’analyse de la langue est un élément clé de l’évaluation de l’état de santé du patient. En pratique, cela implique l’analyse d’images et l’interprétation de caractéristiques visuelles subtiles telles que la couleur, l’enduit, les fissures ou les empreintes dentaires. Ces éléments sont ensuite associés à des syndromes diagnostiques.
Jusqu’à présent, l’ensemble du processus était réalisé manuellement par un expert. Cela limitait la capacité de traitement, car le nombre d’analyses dépendait directement de la disponibilité des spécialistes. Cela allongeait également les délais et introduisait une variabilité naturelle dans l’interprétation. Le client avait besoin d’une solution permettant d’augmenter la capacité sans compromettre la qualité, et à terme d’automatiser partiellement ou totalement le processus.
Défi
Le principal défi n’était pas l’utilisation du deep learning en elle-même, mais la création d’un pipeline d’IA pertinent dans des conditions loin d’un environnement « de laboratoire ».
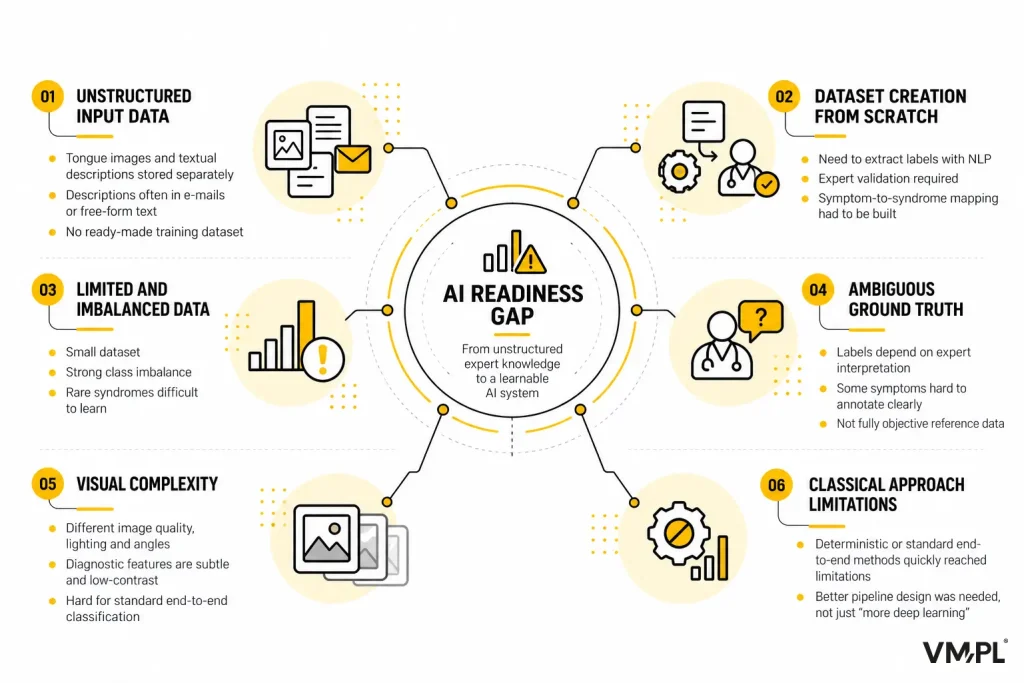
Les données d’entrée étaient non structurées. Les images de langue et leurs descriptions existaient séparément, souvent dispersées dans des échanges d’e-mails, et les descriptions étaient rédigées sous forme de texte libre. Cela signifiait qu’il n’existait pas de dataset d’entraînement prêt à l’emploi et qu’il fallait le construire de zéro, y compris l’extraction des labels à l’aide du NLP et leur validation par des experts.
De plus, le volume de données était limité et la distribution des classes fortement déséquilibrée. Certains syndromes étaient rares, ce qui rendait l’entraînement des modèles selon une approche de classification classique difficile. Le problème était aggravé par le fait que la ground truth n’était pas totalement objective. L’interprétation dépendait de l’expert, et certains symptômes étaient difficiles à annoter de manière cohérente.
D’un point de vue visuel, la situation était également complexe. Les images variaient en qualité, en éclairage et en angle de prise de vue, tandis que les caractéristiques diagnostiques étaient souvent subtiles et peu contrastées. En pratique, cela signifiait qu’une approche classique de classification end-to-end atteignait rapidement ses limites.
Solution
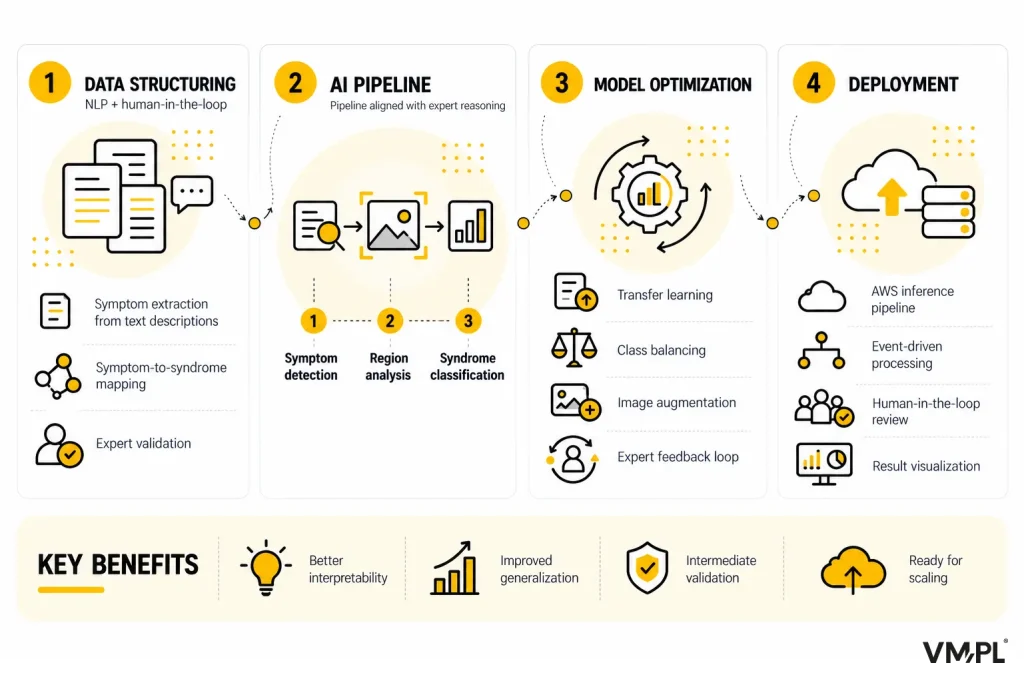
Au lieu d’un modèle de classification unique, nous avons conçu un pipeline aligné sur la logique d’un expert.
1. Structuration des données (NLP + human-in-the-loop)
- extraction des symptômes à partir de descriptions textuelles,
- création d’un dictionnaire de caractéristiques et mapping symptôme vers syndrome,
- validation itérative par un expert.
2. Architecture du modèle (CNN + transfer learning)
Nous avons comparé deux approches :
A. Classification end-to-end des syndromes
Rapide, mais avec une faible interprétabilité et des performances inférieures.
B. Pipeline en trois étapes (approche finale) :
- détection des symptômes (multi-label),
- analyse des régions de la langue (localisation des caractéristiques),
- classification des syndromes.
Pourquoi cette approche fonctionne mieux :
- décomposition du problème en sous-tâches plus simples,
- meilleure généralisation avec un petit dataset,
- possibilité de valider les résultats intermédiaires.
3. Optimisation
- transfer learning avec des CNN pré-entraînés,
- équilibrage des classes,
- augmentation des données d’image,
- validation itérative avec expert et boucle de feedback.
4. Déploiement (PoC prêt pour la production)
- pipeline d’inférence scalable sur AWS,
- traitement événementiel après upload des images,
- visualisation des résultats avec mise en évidence des symptômes,
- mode human-in-the-loop avec validation experte.
Résultats
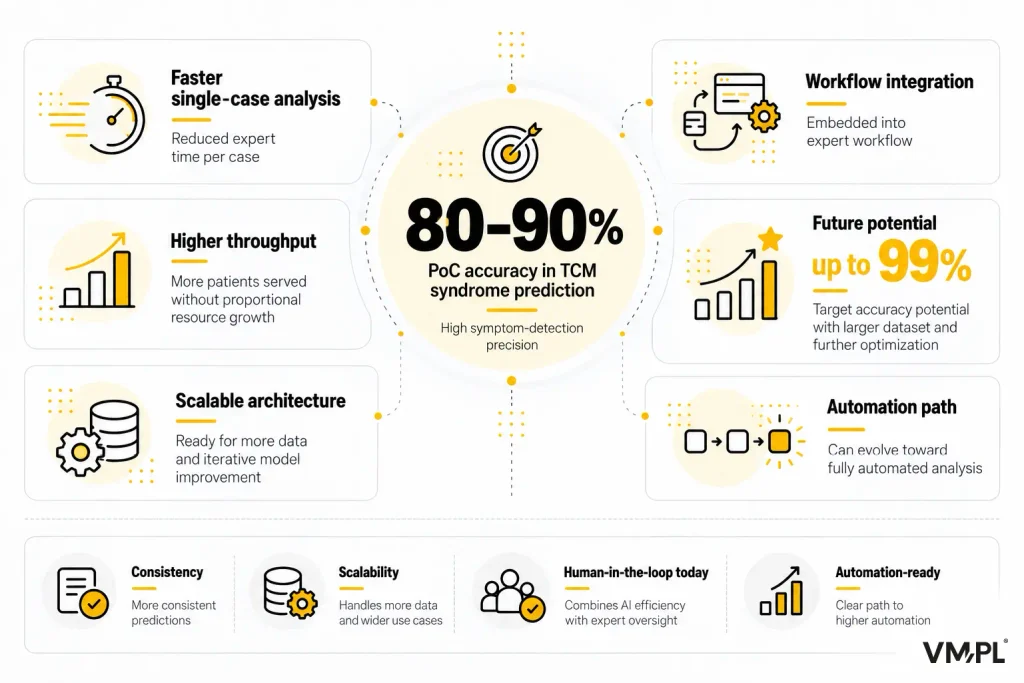
Au stade de Proof of Concept, le système a atteint une précision de 80 à 90 pour cent dans la prédiction des syndromes TCM, tout en maintenant une haute précision dans la détection des symptômes.
Il est important de noter que le modèle reste stable malgré un dataset limité et imparfait, ce qui confirme la pertinence de l’architecture choisie.
D’un point de vue opérationnel, la solution a été intégrée au workflow des experts et a réduit le temps d’analyse par cas. Cela permet de traiter un plus grand nombre de patients sans augmenter proportionnellement les ressources.
L’architecture du système est prête pour des développements futurs, notamment en termes de montée en charge des données et d’amélioration continue des modèles. Avec l’augmentation du dataset et une optimisation continue, un potentiel d’atteindre une précision proche de 99 pour cent a été identifié.
À terme, le système peut évoluer vers un mode entièrement automatisé, où le rôle de l’expert sera réduit ou supprimé, et les résultats seront transmis directement au patient.
Conception, développement, DevOps ou Cloud - de quelle équipe avez-vous besoin pour accélérer le travail sur vos projets ? Discutez avec vos partenaires de consultation pour voir si nous sommes compatibles.
Jakub Orczyk
Membre du Conseil d’administration/Directeur des ventes VM.PL
Réservez une consultation gratuite